
INPUT
Idee, Stoff und Drehbuch
Freitext, Exposee, Drehbuch oder Konzept als Ausgangspunkt.
Ein lernendes System für Filmemacher*innen, Produzent*innen, Studios, Sender und Streaming-Anbieter. Stoffe und kreative Konzepte werden analysiert, gegen offene Datenquellen abgeglichen und in strukturierten Datenblättern zusammengeführt. Jede Nutzung reichert den Bestand an. Daten liefern den Befund, Menschen liefern das Urteil.
01 // MODULE
Jedes Modul löst einen konkreten Engpass im Development-Alltag. Zusammen bilden sie einen geschlossenen Arbeitskreislauf, der mit jeder Sitzung präziser wird.
MODUL A
Der kuratierte Wissensspeicher Ihres Hauses. Stoffe, Talente, Kreative und externe IP-Beobachtungen in einem strukturierten, durchsuchbaren Wiki-Dashboard.
MODUL B
Intelligente Datenblätter, die mit jeder Session wachsen. Automatische Befüllung aus DACH-Quellen, Versions-Historisierung und Rückfluss aus dem Chat in einem Zug.
MODUL C
Fragen in normaler Sprache über den gesamten Datenbestand. An jeder Ziffer hängt Quelle, Erhebungsdatum und Konfidenz. Kein Zitat ohne Beleg.
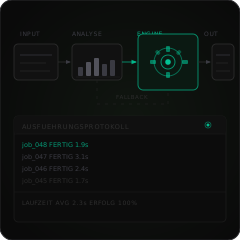
MODUL D
Eine erweiterbare Sammlung offener Datenquellen und Schnittstellen zu Plattformen, Communities und Branchen-Registern. Anbieter-neutral und jederzeit austauschbar.
Schluss mit verstreuten Word-Dokumenten und unauffindbarern Mail-Anhängen. Die Asset Library ist der kuratierte Wissensspeicher für alle Stoffe, Talente, Kontakte und externen IP-Beobachtungen Ihres Hauses. Stoff- und Konzeptakten lassen sich hier anlegen, klassifizieren und für das gesamte Development-Team zugänglich machen.
Jeder Eintrag folgt einem typspezifischen Schema. Felder für Rechte-Status, Besetzungsoptionen, Formatparameter und Markteinordnung sind strukturiert, kein freies Textfeld.
TITEL DER IP
Neuer Fakt extrahiert: "Option für Verfilmung lief am 31.03.2026 ohne Verlängerung aus. Gesprächsbereitschaft signalisiert (Agentur-Mail, verifiziert)."
Kein Datenblatt verstaubt. Sobald Sie einen Stoff oder ein Talent anlegen, sucht ein automatischer Agent die Basisdaten aus verifizierten DACH-Quellen zusammen und formatiert sie einheitlich. Das Flywheel-Prinzip greift konkret: jede Nutzung reichert die Datenblätter an, das System wird mit jedem Lauf besser.
Jedes Gespräch, das Sie oder Ihr Team im Chat über ein Asset führen, fließt als verifizierter Fakt in das Datenblatt zurück. Das System wächst mit jeder Development-Sitzung.
Automatische Befüllung bei Anlage
KI füllt Basisdaten aus DACH-Quellen vor
Kontinuierlicher Re-Sync
Versionierung jeder Änderung mit Zeitstempel
Chat-Fakten fließen zurück
Gesprächsergebnisse mit Bestätigung einpflegen
Stellen Sie komplexe redaktionelle Fragen an Ihren gesamten Datenbestand in normaler Sprache. Der Agent entscheidet im Hintergrund: reichen die intern vorliegenden Daten, oder muss eine gezielte DACH-Marktrecherche angestoßen werden?
An jeder Ziffer hängt der Herkunftsnachweis: Quelle, Erhebungsdatum und Konfidenz. Kein Zitat ohne Beleg. Die KI-Modelle sind anbieter-neutral und austauschbar, einschließlich lokal betriebener Modelle ohne Cloud-Anbindung.
ANFRAGE // DEVELOPMENT:
"Welche Showrunner in Europa haben nachgewiesene Erfahrung mit historischen Stoffen und sind im 2. Halbjahr 2026 noch verfügbar?"4 Profile mit hoher Passung identifiziert. Vollständiges Dossier ab Seite 2.
Zuletzt: Headautor 6-teilige öffentlich-rechtliche Event-Serie (1920er Jahre). Freigabe für Folgeprojekte laut Agentur ab August 2026.
DATENHOHEIT // EUROPE-FIRST
CineCockpit läuft auf EU-Infrastruktur und ist DSGVO-konform konzipiert. Die KI-Schicht ist anbieter-neutral: lokale Modelle sind einsetzbar, keine Abhängigkeit von einem einzigen Anbieter. Drehbücher, Exposés und unveröffentlichte Konzepte verlassen Ihre Instanz nicht.
EU-HOSTING
Standort Deutschland / EU
Alle Instanzen laufen in EU-Rechenzentren. Kein Datentransfer in Drittländer ohne Ihre Freigabe.
AUSTAUSCHBARE MODELLE
Anbieter-neutral
KI-Modell ist konfigurierbar und ersetzbar. Lokale Inferenz möglich. Kein Lock-in.
DSGVO
Zero-Retention für Recherchen
Externe Recherche-Anfragen werden nicht dauerhaft gespeichert. AVV-Vertrag auf Wunsch.
02 // TAXONOMIE
Jeder Typ besitzt ein Datenschema, das an den realen Gepflogenheiten der europäischen Film- und Fernsehindustrie ausgerichtet ist.
Schauspieler, Comedians, Creators und Influencer mit relevantem Publikumstransfer. Profiliert nach Zielgruppensegment, Dialektkompetenz und Reichweitendaten aus offenen Plattform-Quellen.
Regie, Drehbuchautoren, Showrunner, Producer und kinematografische Schlüsselfiguren, erfasst mit Filmografie, Genreprofil und Verfügbarkeit.
Romane, Sachbücher, Graphic Novels, Theaterstücke und verbürgte Lebensrechte. Mit Auflagendaten aus DACH-Buchmarktquellen und offenen Werk- sowie Metadaten-Registern. Stoffe werden gegen diese Datenbank abgeglichen.
Games, Storytelling-Podcasts, Web- und Kurzvideoformate, Audio-Dramen, Musikkataloge: Formate, die in klassischen Development-Datenbanken fehlen.
Ihre eigenen Stoffe im Entwicklungsstadium: von der 2-Seiten-Ideenskizze über Treatment und Drehbuch bis zum fertigen Pitchdeck. CineCockpit ordnet Ideen, Exposés, Treatments und Drehbücher nach Entwicklungsstand ein, findet passende Vergleichsstoffe und zeigt, welche Zielgruppen der Stoff ansprechen könnte. Die Analyse-Ergebnisse fließen direkt in die Projektakte ein. Verknüpft mit Talent-, Markt- und Förderprofilen.
03 // BETRIEBSMODI
Ob Sie den Markt nach frischen Impulsen scannen, ein eingereichtes Paket prüfen oder eine tiefgehende Verhandlung vorbereiten.
RADAR FÜR OPPORTUNITIES
Kontinuierlicher Radar über den deutschsprachigen Buch- und Rechtemarkt. Entdecken Sie neu erschienene Titel, prämierte Theaterstücke und noch unbesetzte IPs, bevor sie den großen Sendern angeboten werden.
EINORDNUNG EINES PACKAGES
Ihnen wird ein Buch oder Drehbuch angeboten? Geben Sie das Package ein. CineCockpit gleicht Tonalität, Besetzungsvorschläge und Marktumfeld mit bisherigen DACH-Produktionen ab.
6 DATENBLÖCKE PRO ASSET
Umfassende Tiefenanalyse zu einem konkreten Asset. Generiert eine strukturierte 6-teilige Matrix: Rechtslage, Track-Record, Verwertungskette, Zielgruppensegmente, Förderkompatibilität, Vergleichstitel.
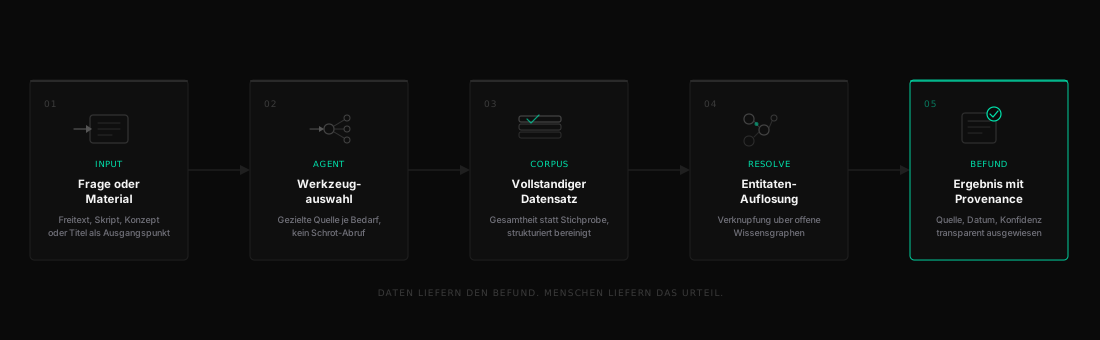
WORKFLOW // PROZESS-ÜBERBLICK
04 // KERN-WORKFLOWS
Von der schnellen Vergleichsfrage bis zum vollständigen Exposé-Import.
Sie tippen eine redaktionelle Frage: "Welche ähnlichen Stoffe liefen in den letzten 3 Jahren im öffentlich-rechtlichen Hauptprogramm DACH, und welche Reichweiten erzielten sie?" Der Agent sucht zunächst in Ihrer Bibliothek, ergänzt anschliessend aus verifizierten DACH-Mediathek-Daten und liefert das Ergebnis mit vollständiger Quellenangabe.
Für ein konkretes Asset wird eine vollständige 6-Block-Analyse generiert:
Gezielte Marktanalyse für ein Genre oder Thema. Das System prüft, welche Stoffe aktuell in DACH-Mediatheken präsent sind (Angebot), wo das Publikumsinteresse liegt (Nachfrage aus Stimmungs- und Suchdaten) und zeigt die daraus entstehende Lücke als konkrete Chance. Stoffe werden dabei gegen offene Quellen und Plattform-Signale abgeglichen.
Laden Sie eine Logline, ein Exposé oder ein Treatment hoch. CineCockpit führt eine automatische Stoff- und Drehbuchanalyse durch: Das System ordnet Ihre Idee nach Entwicklungsstand ein (Exposé, Treatment, Drehbuch), erkennt passende Vergleichstitel, benennt mögliche Zielgruppensegmente und liefert erste Recherchehinweise. Alle Ergebnisse werden Ihnen zur Freigabe angezeigt.
WORKFLOW // END-TO-END-STREAMLINE
Sechs Stufen. Ein durchgängiger Prozess. Daten liefern den Befund, Menschen liefern das Urteil.
INPUT
Freitext, Exposee, Drehbuch oder Konzept als Ausgangspunkt.
ANALYSE
Extraktion von Genre, Tonalität, Figuren und Formatparametern.
ABGLEICH
Strukturierter Abgleich gegen offene Quellen und Publikumssignale.
PROPRIETÄRE KI
EU-Infrastruktur, austauschbar und selbst hostbar. Keine Drittland-Abhängigkeit.
BEFUND
Vergleichsstoffe, Zielgruppen-Match und belegte Quellen mit Konfidenz.
OUTPUT
Handlungsempfehlung für digitale Kanäle auf Basis des Marktbefunds.
05 // VERMARKTUNG / GO-TO-MARKET
CineCockpit liefert zum Stoff auch einen datengestützten Vermarktungsansatz: passende Zielgruppen, geeignete digitale Kanäle aus den Bereichen Social Media und Community, Timing-Hinweise und vergleichbare Kampagnen-Muster aus dem DACH-Markt. Alles als Vorschlag und Befund. Die Entscheidung trifft der Mensch.
Prognose als Einordnungn, keine Garantien, keine erfundenen Reichweitenzahlen. Der Vermarktungsansatz ist ein strukturierter Ausgangspunkt für das kreative und strategische Team.
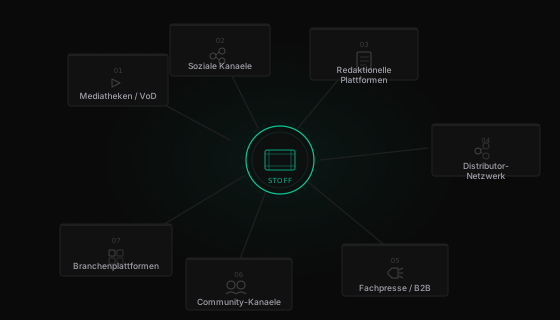
Auf Basis der Vergleichsstoffe und Publikumssignale benennt CineCockpit konkrete Zielgruppen-Segmente für den Stoff. Alter, Region, thematische Affinitäten aus aggregierten, nicht-personenbezogenen Resonanz-Daten.
Das System zeigt, auf welchen digitalen Kanälen und in welchen thematischen Communities vergleichbare Stoffe besonders stark resonieren. Social-Media-Plattformen, Foren, Fan-Communities und Streaming-Diskurse werden ausgewertet.
Vergleichbare Kampagnen aus dem DACH-Markt zeigen, welche Phasen und Zeitfenster für vergleichbare Stoffe genutzt wurden. Muster aus öffentlich zugänglichen Kampagnendaten, keine proprietären Mediaplandaten.
Der Vermarktungsansatz für einen Stoff wird in das jeweilige Living Sheet geschrieben. Alle Empfehlungen tragen Quellennachweis und Konfidenz. Kein Einpflegen ohne Ihre Bestätigung.
ZIELGRUPPEN-SEGMENT
25-45 Jahre, DACH, Crime-affin, urban
Abgeleitet aus Publikumsresonanz Vergleichsstoffe Dark (2017) / Kleo (2022)
EMPFOHLENE KANÄLE
Social Video, Crime-Communities, Newsletter-Formate
Resonanz vergleichbarer Stoffe besonders stark auf Video-Plattformen und thematischen Foren
TIMING-MUSTER
Herbst-Fenster (Okt-Nov), 6-8 Wochen Vorlauf
Muster aus DACH-Kampagnendaten vergleichbarer Serienstarts (öffentlich zugänglich)
06 // DATEN-ENGINE
CineCockpit greift auf eine erweiterbare Sammlung offener Datenquellen und Schnittstellen zu Plattformen, Communities und Datenbanken zurück. Alle Anbindungen sind anbieter-neutral und austauschbar. Der Agent wählt je Fragestellung gezielt aus, löst Entitäten über offene Wissensgraphen auf und liefert das Ergebnis mit Quellenbeleg, Datum und Konfidenz. Kein Black-Box-Score, kein automatisches Greenlight.
Besetzungen, Filmografien und internationale Identifikatoren aus öffentlich lizenzierten Werk- und Metadaten-Registern.
Entitäten-Auflösung über offene Wissensgraphen und Linked-Data-Register. Basis für saubere Zuordnung ohne Duplikate.
Aggregierte Nachfrage- und Reichweiten-Signale öffentlicher Plattformen und Community-Datenquellen. DACH-gewichtet, zeitreihenfähig. Kein personenbezogenes Tracking.
Publikumsresonanz bei Soundtracks, Trailer-Reichweite und Streaming-Aktivierung bei Buchverfilmungen aus öffentlichen Quellen.
Streaming-Nachfrage-Indikatoren für DACH und EU aus öffentlichen Plattform-Daten. Vergleichstitel-Recherche für Filmproduktion und Lizenzierung.
Sentiment-Daten, Auflagen und Bestsellerlisten für Literatur-IP in Europa aus öffentlichen Buchhandels-Datenbanken.
Spezialisierte Branchennetze für Filmschaffende in Europa. Filmografien, Verfügbarkeiten, Genreprofile aus offenen Branchenquellen.
Öffentliche Produktionsdaten, Ausstrahlungen, Mediathek-Präsenz der ARD, des ZDF sowie öffentlich-rechtlicher Angebote aus AT und CH. Wettbewerbs- und Marktanalyse DACH.
Fragestellung auf Deutsch: Stoff, Genre, Vergleich, Marktlage.
Automatische Auswahl der relevanten Schnittstellen und Datenquellen je nach Fragetyp.
Vollständiger Korpus, keine Stichprobe. Entitäts-Auflösung über offene Wissensgraphen.
Ergebnis mit Quelle, Erhebungsdatum, Konfidenz und Kostentransparenz je Lauf.
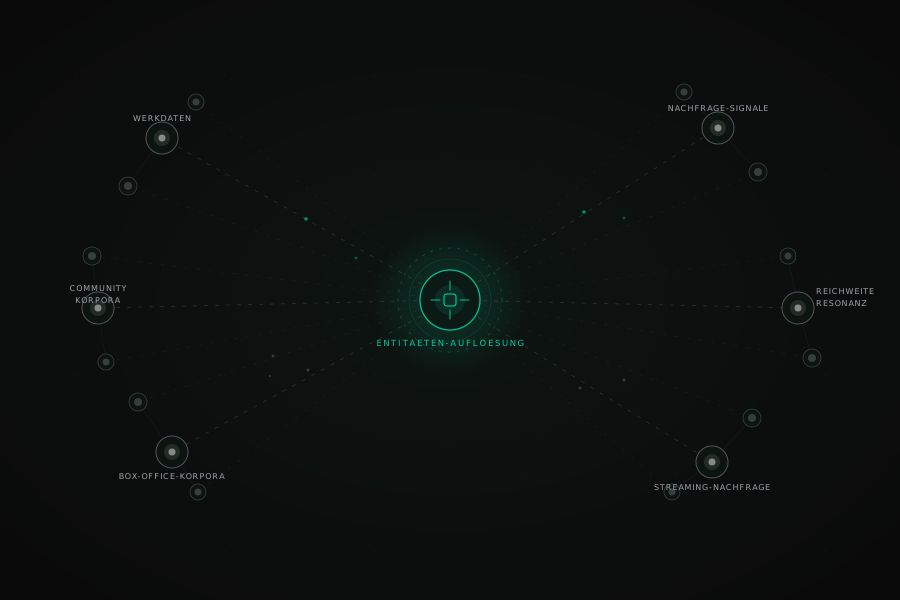
ILLUSTRATION // Vernetzung offener Datenquellen, Signale und Entitäten-Register. Die Engine wählt je Anfrage gezielt aus dem verfügbaren Quellenpool.
07 // CHAT-ABLAUF
Sie stellen eine Frage in normaler Sprache. Im Hintergrund wählt ein Agent gezielt Werkzeuge und Quellen aus, gleicht die Daten ab und gibt Ihnen eine Antwort, an der jede Aussage mit Quelle, Erhebungsdatum und Konfidenz belegt ist. Kein Zitat ohne Beleg.
Mikrogenre: Alpen-Noir / Ensemble-Drama. Hohe Zuschauerresonanz in AT und Bayern.
Sie beschreiben Ihr Rechercheziel so, wie Sie es einem Kollegen erklären würden. Kein Code, keine Filter-Syntax.
Das System entscheidet automatisch: interne Bibliothek, externe DACH-Quellen oder beides. Jeder Schritt ist nachvollziehbar.
Titel, Personen und Marken werden über offene Wissensgraphen eindeutig zugeordnet. Kein Raten, kein Duplikat-Problem.
Jede Aussage trägt Quelle, Erhebungsdatum und Konfidenz. Auf Wunsch fließen Ergebnisse direkt in das Living Sheet des betreffenden Assets zurück.
08 // TECHNOLOGIE
CineCockpit ist auf einer KI-Schicht aufgebaut, die vollständig in Europa entwickelt wurde und dort betrieben wird. Als Sprachmodell arbeiten wir mit Mistral, einer in Frankreich entwickelten KI, die zu den führenden europäischen Sprachmodellen zählt. Modelle sind austauschbar und können lokal oder self-hosted betrieben werden, ohne Cloud-Abhängigkeit von Drittanbietern ausserhalb der EU.
Als Sprachmodell arbeiten wir mit Mistral, einer in Europa entwickelten KI. Mistral AI hat seinen Sitz in Paris und stellt Modelle bereit, die auf EU-Infrastruktur betrieben werden können. Die Modelle sind für mehrsprachige Inhalte im DACH-Raum besonders geeignet.
Die KI-Schicht ist konsequent austauschbar konzipiert. Mistral ist das Standardmodell. Auf Wunsch können andere Modelle, einschliesslich lokal betriebener Open-Source-Varianten, ohne Architektur-Eingriff eingesetzt werden. Kein Vendor-Lock-in.
DSGVO-KONFORM
Externe Recherche-Anfragen werden nicht dauerhaft auf Modell-Seite gespeichert. Unveroffentlichte Stoffe, Exposés und Drehbücher verlassen Ihre Instanz nicht. AVV-Vertrag auf Wunsch.
EU-HOSTING
Alle Instanzen werden in Rechenzentren in Deutschland oder der EU betrieben. Kein unbeaufsichtigter Datenabfluss in Drittländer. Standort ist wählbar und vertraglich fixierbar.
DATENHOHEIT
CineCockpit wird als dedizierte Instanz pro Haus betrieben. Keine Multi-Tenant-Vermischung, keine Nutzung Ihrer Daten für Modell-Training ausserhalb Ihrer Instanz.
TRANSPARENZ
Jede Antwort des Systems trägt Quelle, Datum und Konfidenz. Das Modell erfindet keine Fakten. Es verarbeitet, was Sie hineinbringen, und was aus verifizierten Quellen stammt.
09 // RESONANZ-DATEN
Stoffe und Themen werden nicht nur gegen Film- und Buchmarkt-Datenbanken geprüft, sondern auch gegen Signale aus sozialen Netzwerken und thematischen Communities. So entsteht ein vollständiges Bild: was ist auf Plattformen und in Zielgruppen-Communities präsent, worüber sie gesprochen wird und wie das Publikum reagiert.
Stoffe werden gegen Werk- und Metadaten-Register, Buchhandels-Datenbanken, Förder-Datenbanken und Branchen-Register abgeglichen. Alles auf Basis offentlich zugänglicher oder lizenzierter Quellen.
Aggregierte Signale aus öffentlich zugänglichen sozialen Kanälen und thematischen Communities zeigen, wie stark ein Thema oder eine IP im Gespräch ist. Keine personenbezogenen Rohdaten, kein individuelles Tracking. DSGVO-konform.
Ideen, Exposés, Treatments und Drehbücher werden analysiert und gegen die Datenbasis abgeglichen. CineCockpit erkennt Vergleichsstoffe, Zielgruppen-Signale und Marktlücken auf Basis des konkreten Materials.
FLYWHEEL-PRINZIP
CineCockpit lernt aus jeder Recherche-Sitzung. Neue Fakten, die im Chat erarbeitet werden, fließen zurück in die Living Sheets des jeweiligen Assets. Mit jeder Sitzung wird der Datenbestand präziser und vollständiger. Das System wachst mit dem Haus.
10 // SIGNAL-TYPEN
Der Befund entsteht aus mehreren Signaltypen, die der Agent je nach Fragestellung kombiniert. Daten liefern den Befund, Menschen liefern das Urteil.
SIGNAL // TREND
Steigende Themen und Stoffe werden kanalübergreifend erfasst: aus Suchinteresse-Signalen, Video-Trends und Community-Diskursen. Das Ergebnis ist eine Trendkurve als Zeitreihe, kein einmaliger Schnappschuss. So wird erkennbar, ob ein Thema gerade anzieht oder bereits seinen Zenit überschritten hat.
SIGNAL // SOCIAL
Aggregierte Erwähnungen und Resonanz werden über Social-Media-Kanäle und thematische Communities ausgewertet. Die Auswertung erfolgt auf Basis öffentlich zugänglicher, aggregierter Daten. Keine personenbezogenen Rohdaten, kein individuelles Tracking. DSGVO-konform konzipiert.
SIGNAL // SENTIMENT
Tonalität zu Stoff und Marke wird aus öffentlichen Korpora ermittelt und durch Mistral, die europäische KI, ausgewertet. Das Ergebnis zeigt, ob ein Thema, eine IP oder ein Kreativprofil im öffentlichen Diskurs positiv, kritisch oder kontrovers wahrgenommen wird. Kein Black-Box-Score: Quelle und Konfidenz sind immer ausgewiesen.
SIGNAL // MARKT
Box-Office- und Streaming-Nachfrage-Daten liefern den Marktkontext für Vergleichsstoffe. Prognosen sind datengestützte Einordnungen mit ausgewiesener Konfidenz, kein automatisches Greenlight-Versprechen. Die Einordnung hilft dem Development-Team, Marktlage und Wettbewerbs-Pipeline realistisch einzuschätzen.
11 // STOFF- UND KONZEPTPRUEFUNG
CineCockpit prüft nicht nur Marktdaten und externe IPs, sondern ordnet auch Ihre eigenen kreativen Konzepte und Drehbücher ein. Ideen, Exposés, Treatments und fertige Drehbücher werden analysiert, mit Vergleichsstoffen abgeglichen und im Marktkontext verortet. Das Ergebnis ist ein Befund, kein Urteil: Daten liefern den Befund, Menschen liefern das Urteil.
Das System liest Ihr Material (Logline, Exposé, Treatment, Drehbuch) und extrahiert automatisch ein strukturiertes Stoffprofil: Genre, Mikrogenre-Tags, Schauplatz, Besetzungstyp, Formatparameter. Alle Felder werden Ihnen zur Prüfung angezeigt, bevor etwas gespeichert wird.
CineCockpit gleicht das Profil mit dem gesamten Bibliotheksbestand und verifizierten DACH-Produktions-Daten ab. Vergleichsstoffe werden nach Tonalität, Genre-Nähe und Formattyp gerankt. Jeder Treffer trägt Quelle und Konfidenz.
Auf Basis von Publikumssignalen der gefundenen Vergleichsstoffe zeigt CineCockpit, welche Zielgruppen-Segmente für das eingereichte Material infrage kommen. Der Abgleich basiert auf aggregierten, nicht-personenbezogenen Resonanz-Daten.
Das System ordnet ein, wo sich Ihr Material im Entwicklungsprozess befindet (Idee, Exposé, Treatment, Drehbuch) und liefert Hinweise auf Marktlücken, Foerderkompatibilitaet und Wettbewerbs-Pipeline im DACH-Raum.
ENTWICKLUNGSSTAND
Treatment (22 Seiten)
Erkannt: Dialogszenen, Figurenentwicklung, 3-Akt-Struktur
VERGLEICHSSTOFFE (TOP 2)
Dark (2017, öff.-r.) / Kleo (2022)
Genre-Nähe: Alpen-Noir // Konfidenz: hoch
ZIELGRUPPE
35-55 Jahre, DACH, Thriller-affin
Signal aus Publikumsresonanz der Vergleichsstoffe
NÄCHSTER SCHRITT
In einer 30-minütigen Live-Session demonstrieren wir CineCockpit anhand eines Ihrer realen Recherche-Szenarien oder einer anonymisierten IP.
Demo anfragen